Az MI térnyerése a világhálón
SZEMLÉZŐ
Friss kutatások, tanulmányok és szakmai publikációk nyomában
Visokay, A. és mtsai (2026). The uneven rise of AI-generated web content.
arXiv, 2610.36631v1 [cs.AI].
Megjelenés: 2026. október 27.
Műfaj: Tudományos kutatási tanulmány, preprint (lektorálás előtti kézirat)
DOI: https://doi.org/10.48550/arXiv.2610.36631
Egyre több MI által generált tartalom a világhálón
A generatív mesterséges intelligencia térnyerése nemcsak az alkalmazások használatában, hanem a világhálón közzétett szövegekben is nyomon követhető. Egy 2026 októberében megjelent kutatás szerint az MI által generált vagy MI segítségével szerkesztett szöveget tartalmazó weboldalak aránya néhány év alatt jelentősen megnőtt. A változás ráadásul nem egyenletes: a növekedés üteme gyorsul, miközben a különböző nyelveken és webes környezetekben eltérő mértékben jelentkezik.
Adam Visokay és munkatársai a Common Crawl internetes archívumának 2019 januárja és 2026 augusztusa közötti adatait elemezték. A kutatás 71 webes feltérképezésből származó, több mint 5,1 millió weboldalt fogott át. A vizsgálatba azok az oldalak kerülhettek be, amelyekből legalább 500 karakternyi érdemi szöveg volt kinyerhető.
A kutatók becslése szerint 2026 augusztusára a vizsgált feltételeknek megfelelő weboldalak 23,6%-a tartalmazott MI által generált vagy MI segítségével szerkesztett szöveget. Ez azt jelenti, hogy a feltérképezhető webes szövegállományban közel minden negyedik oldal esetében valószínűsíthető volt az MI közreműködése.
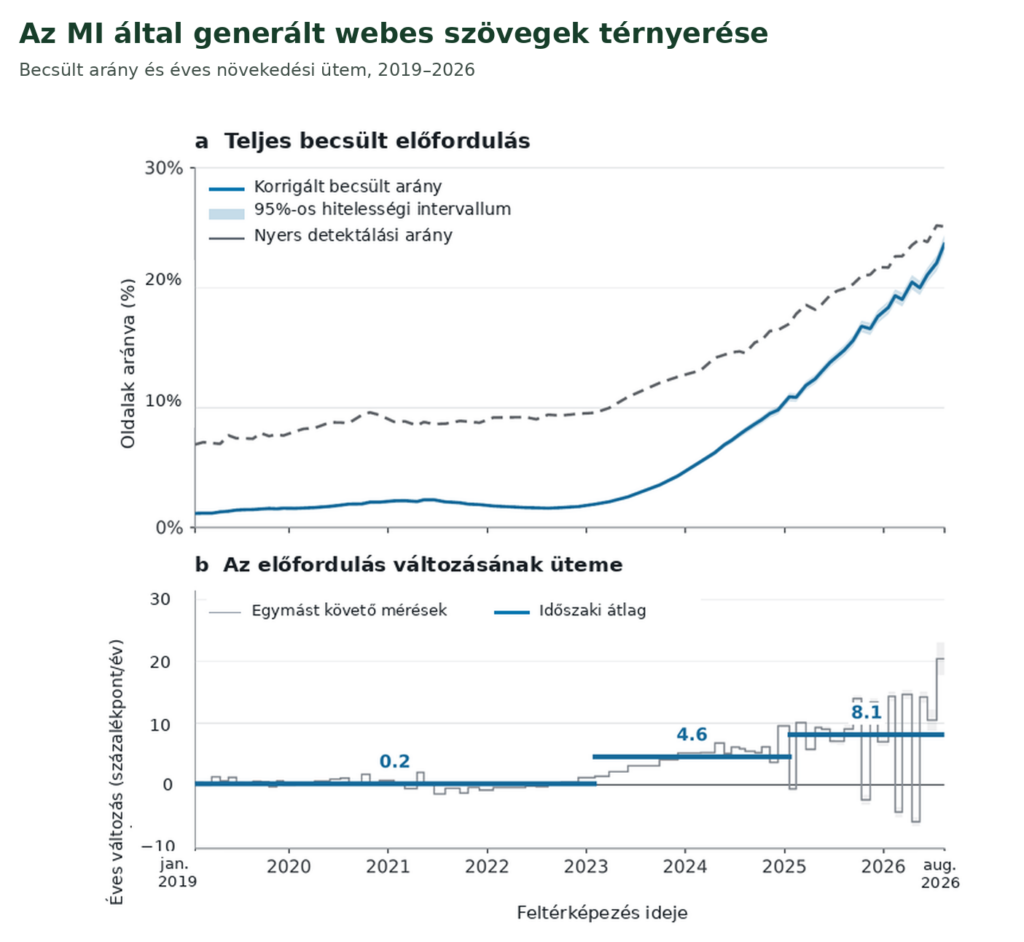
1. ábra. Az MI által generált vagy szerkesztett szöveget tartalmazó weboldalak becsült aránya és éves növekedési üteme (2019–2026). Forrás: Visokay és mtsai (2026), 2.1. ábra alapján.
Magyar nyelvű átdolgozás: Router Learning CC BY 4.0.
Nemcsak a jelenlét, hanem a növekedés üteme is változik
Az ábra egyik legfontosabb tanulsága a növekedés felgyorsulása. A kutatók három időszakot különítettek el. 2019 januárja és 2023 februárja között az MI-tartalmú oldalak becsült aránya évente átlagosan mindössze 0,2 százalékponttal növekedett. 2023 februárja és 2025 januárja között az éves átlagos növekedés már 4,6 százalékpont volt, 2025 januárjától 2026 augusztusáig pedig 8,1 százalékpontra emelkedett.
A két utóbbi időszak összehasonlítása különösen figyelemre méltó, mert az MI által generált vagy szerkesztett szöveget tartalmazó oldalak aránya nem egyszerűen tovább emelkedett, hanem a növekedés üteme közel megkétszereződött.
A százalékpontban kifejezett változást azonban fontos elkülöníteni a weboldalak darabszámának növekedésétől. A kutatás az adott időpontban feltérképezhető, a vizsgálati feltételeknek megfelelő oldalak között becsülte meg az MI-tartalmat hordozó oldalak arányát. Nem azt állapította meg, hogy évente pontosan hány új MI-tartalmú weboldal jött létre.
Ez a különbség azért is lényeges, mert az internet tartalomállománya folyamatosan változik. Új oldalak jelennek meg, régiek eltűnnek vagy módosulnak, és maga a feltérképezhető webes állomány sem állandó.
Az eredmények arra utalnak, hogy a generatív MI egyre jelentősebb szerepet kap a nyilvánosan hozzáférhető szövegek előállításában és szerkesztésében. Ez nemcsak az online tájékozódás szempontjából fontos: a világhálón elérhető szövegek a későbbi nyelvi modellek tanítóadatainak is alapvető forrásai lehetnek.
Nem egyformán terjed az MI a világhálón
A tanulmány címében szereplő egyenlőtlen térnyerés arra utal, hogy az MI által generált tartalmak elterjedése nem azonos ütemben zajlik a web különböző területein. A kutatók három meghatározó szempontot vizsgáltak: a weboldalak nyelvét, a domének típusát és a webes hivatkozási hálózatban elfoglalt helyüket.
Az angol nyelvű weboldalakon gyorsabb a térnyerés
A kutatás egyik legmarkánsabb eredménye az angol és a nem angol nyelvű weboldalak közötti különbség.
2026 augusztusában a kizárólag angol nyelvű oldalak becslések szerint 32,8%-a tartalmazott MI által generált vagy szerkesztett szöveget, míg a kizárólag nem angol nyelvű oldalak esetében ez az arány 17% volt.
2023 februárjában a két csoport közötti eltérés még mindössze 0,6 százalékpont volt, 2025 januárjára 6,5 százalékpontra, 2026 augusztusára pedig 15,8 százalékpontra emelkedett.
A kutatók azt is kimutatták, hogy 2025 januárja és 2026 augusztusa között a kizárólag angol nyelvű oldalak körében évente átlagosan 10,8 százalékponttal növekedett az MI-tartalom becsült előfordulása, míg a nem angol nyelvű oldalaknál 4,8 százalékponttal. Az MI által generált webes szövegek terjedése tehát az angol nyelvű tartalmak körében nemcsak előrehaladottabb, hanem gyorsabb is.
Az eredmény értelmezésénél azonban módszertani óvatosság szükséges. A vizsgálat a nem angol nyelvű oldalakat összevont kategóriaként kezeli, miközben az MI-detektorok teljesítményének ellenőrzése csak korlátozott számú nyelvre terjedt ki. A magyar nyelv nem szerepelt a részletes detektorkalibrálásban.
Ezért a 17%-os érték nem tekinthető a magyar nyelvű weboldalakra vonatkozó becslésnek. A tanulmány nem szolgáltat közvetlen adatot arról, hogy a magyar webes szövegállomány milyen arányban tartalmaz MI által generált vagy szerkesztett tartalmakat.
A kereskedelmi és intézményi oldalak között is jelentős a különbség
A kutatók a legfelső szintű domének (top-level domains, TLD-k) alapján is összehasonlították a weboldalakat.
A 2026 augusztusára vonatkozó becslések szerint a .com végződésű oldalakon 29,5%, a .net doméneken 20,4%, a .org végződésű oldalakon 14,6% volt az MI által generált vagy szerkesztett szövegek előfordulása. Ezzel szemben az oktatási intézményekhez kapcsolódó .edu doméneken 6,1%, a kormányzati .gov doméneken pedig 5,8% volt ugyanez az arány.
A különbségek akkor is jelentősek maradtak, amikor a kutatók statisztikai modelljükben figyelembe vették a weboldalak nyelvét, szöveghosszát és hálózati helyzetét. Az eredmények arra utalnak, hogy az MI-tartalmak térnyerése nem csupán a weboldalak nyelvi összetételétől függ. A különböző doménkategóriákban eltérő tartalom-előállítási gyakorlatok érvényesülhetnek, de a tanulmány ezek okait közvetlenül nem vizsgálja.
A .edu és .gov kategóriák ugyanakkor nem azonosíthatók általában a világ oktatási és kormányzati weboldalaival. A különböző országok intézményei más doménvégződéseket is használnak, ezért az eredményeket nem lehet közvetlenül valamennyi ország intézményi webes környezetére általánosítani.
A web hálózati perifériáján a legerőteljesebb a növekedés
A tanulmány egyik sajátos megközelítése, hogy az MI-tartalmú oldalak elterjedését a web hivatkozási hálózatában elfoglalt helyük alapján is vizsgálja. A kutatók a PageRank algoritmus segítségével hat csoportba sorolták a doméneket. A központibb doménekhez több, illetve nagyobb hálózati jelentőségű doménről vezetnek hivatkozások, míg a periférián található oldalak kevésbé kapcsolódnak a web meghatározó csomópontjaihoz.
A 2026 augusztusi adatok szerint a legközpontibb doménekhez tartozó oldalakon 11,6%, a legkevésbé központi doménekhez tartozó oldalakon viszont 27,5% volt az MI által generált vagy szerkesztett szöveget tartalmazó oldalak becsült aránya.
A két legkevésbé központi csoport együttesen a vizsgálatba bevonható weboldalak 70,5%-át képviselte, és a 2021 decembere és 2026 augusztusa között megfigyelt teljes aránynövekedés 78,8%-áért felelt.
Ez különösen figyelemre méltó eredmény. A webes szövegállomány MI-vel összefüggő átalakulása jelentős részben nem a legnagyobb hálózati beágyazottságú doménekhez, hanem a kevésbé központi oldalakhoz köthető.
A kutatás azonban nem bizonyít oksági kapcsolatot a hálózati periférián elfoglalt helyzet és az MI-használat között. A PageRank szerinti besorolás összefüggést mutat az MI-tartalmak előfordulásával, de önmagában nem magyarázza meg, miért gyorsabb a növekedés ezekben a csoportokban.
Mennyire bízhatunk az MI-detektálás eredményeiben?
Az eddig bemutatott eredmények egy további kérdést vetnek fel: hogyan állapítható meg több millió weboldalról, hogy szövegének előállításában vagy szerkesztésében részt vett-e mesterséges intelligencia?
A kutatás módszertani jelentősége éppen abban áll, hogy a szerzők nem tekintik az MI-detektorok eredményeit tévedhetetlen besorolásnak. A detektorok tévesen is MI által generáltnak minősíthetnek emberi szövegeket, miközben valóban MI által létrehozott tartalmakat is felismerés nélkül hagyhatnak. A tanulmány bevezetésében az MI-detektálást a következőképpen közelítik meg:
“AI detection as a measurement error problem.”
„Az MI-detektálást mérési hibával terhelt problémaként [értelmezik].” (Saját fordítás, 2. o.) Ez a megközelítés lényeges különbséget jelent a detektorok eredményeinek egyszerű összesítéséhez képest. A kutatók többféle detektáló eszközt értékeltek, majd a kiválasztott modellek hibaarányait is figyelembe vették a becslések elkészítésekor.
Különösen érdekes, hogy a 2022 előtti webes szövegállományt kontrolladatként használták. Mivel ebben az időszakban a ma ismert generatív nyelvi modellek használata még nem volt elterjedt, a kutatók a korai adatok segítségével vizsgálhatták, milyen gyakran jelölnek a detektorok MI által létrehozottnak olyan szövegeket, amelyek nagy valószínűséggel emberi eredetűek.
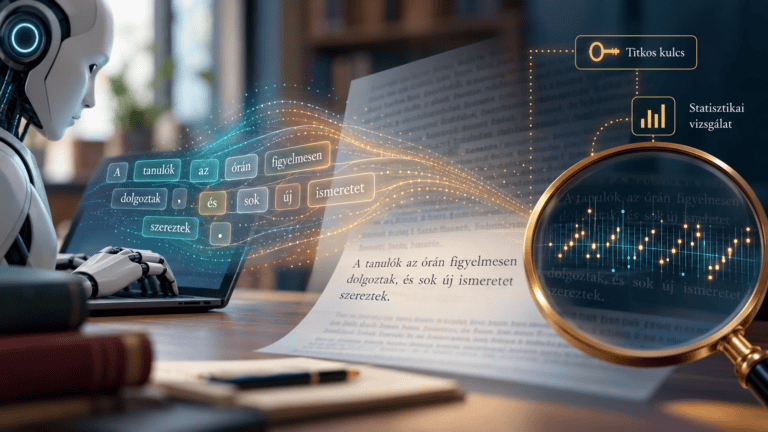
A hibaarányok figyelembevételére Bayes-féle hierarchikus statisztikai modellt alkalmaztak. Ennek segítségével nem egyszerűen a detektorok által megjelölt oldalak arányát közölték, hanem a téves besorolásokkal korrigált becsléseket.
Mindez azonban nem jelenti azt, hogy az eredmények teljes bizonyossággal leírnák az egyes szövegek eredetét. A szerzők maguk is hangsúlyozzák: a detektorok kimenetei a szerzőségre utaló, bizonytalanságokkal terhelt mérési eredmények, és nem tekinthetők a szerzőség megállapításához elegendő bizonyítéknak.
Amikor a web saját szövegeiből tanul
A tanulmány olvasása közben számomra nem önmagában a közel 24%-os arány a legérdekesebb. Sokkal inkább az, hogy a generatív mesterséges intelligencia néhány év alatt olyan mértékben jelent meg a webes szövegalkotásban, hogy ma már a nyilvános szövegkörnyezetünk alakításának egyik meghatározó szereplője.
Ez pedagógiai szempontból is fontos változás. A digitális szövegértés és a forráskritika tanításakor korábban elsősorban azt vizsgáltuk, ki hozta létre az adott tartalmat, milyen céllal, milyen forrásokra támaszkodva, és mennyire tekinthető hitelesnek. Ezek a kérdések továbbra is érvényesek, de az MI megjelenésével új szemponttal egészülnek ki: milyen szerepe lehetett egy nyelvi modellnek a szöveg létrehozásában?
A kérdésre azonban nem feltétlenül adható egyértelmű válasz. Egy szöveg készülhet teljes egészében emberi munkával, létrejöhet nyelvi modell segítségével, vagy tartalmazhat különböző mértékű gépi szerkesztést. Az ilyen együttműködések határai nem mindig azonosíthatók megbízhatóan pusztán a kész szöveg alapján.
Éppen ezért az MI-detektálás eredményeit az oktatásban is körültekintően kell értelmeznünk. Egy detektor által jelzett magas valószínűség önmagában nem bizonyítja, hogy a tanuló nem saját munkáját adta be. A szövegalkotás folyamatának megismerése, a források használata, a tanuló döntéseinek és önálló gondolatainak vizsgálata továbbra is nélkülözhetetlen.
A kutatás ugyanakkor egy ennél tágabb összefüggésre is ráirányítja a figyelmet. A világhálón közzétett szövegek nemcsak az emberi tájékozódás forrásai, hanem a következő generációs nyelvi modellek tanítóanyagai is lehetnek.
Ha ezekben a szövegállományokban egyre nagyobb arányban jelennek meg korábbi nyelvi modellek által létrehozott tartalmak, akkor az újabb modellek közvetve saját elődeik nyelvi megoldásaiból, stílusából és szövegalkotási mintázataiból is tanulhatnak.
Ez a folyamat hosszabb távon nemcsak azt befolyásolhatja, milyen információkhoz jutunk hozzá, hanem azt is, milyen szövegeket tekintünk természetesnek, megszokottnak vagy követendőnek.
A saját szemszögemből ezért a tanulmány legfontosabb tanulsága nem kizárólag az MI által generált tartalmak mennyiségéhez kapcsolódik. Sokkal inkább ahhoz, hogy a digitális műveltség fejlesztésében egyre nagyobb szerepet kell kapnia a tudatos forráshasználatnak, a szöveg eredetére vonatkozó állítások kritikus értékelésének és az önálló szövegalkotásnak.
Nem elegendő felismernünk, hogy a világháló szövegállománya átalakul. Azt is meg kell tanulnunk – és tanítanunk –, hogyan tájékozódjunk ebben a megváltozott szövegkörnyezetben.
A szövegek eredetének megbízható azonosítása más kutatási irányokban is fontos kérdés. A láthatatlan statisztikai vízjelezés lehetőségeit egy korábbi írásomban mutattam be, amelyben az MI-generált szövegek eredetének követhetőségét vizsgáltam.
A tudatos MI-használat kérdését a gondolkodási folyamatok oldaláról közelítettem meg az MI-műveltség mint kognitív védőfaktor – amikor a gondolkodást is átadjuk című cikkemben.