Láthatatlan vízjelek az MI-generált szövegekben – A textGrain lehetőségei és korlátai
SZEMLÉZŐ
Friss kutatások, tanulmányok és szakmai publikációk nyomában
Xiang Li, Garrett Wen, Xiaohong Chen, Qi Long, Arzav Jain, Florent Joly, Mike Lam, Qingquan Song és Weijie Su: textGrain: Entropy-Calibrated Watermarking for Language Model Text.
Megjelent: 2026. október 5.
Eredeti tanulmány: textGrain – teljes technikai jelentés (PDF, 20 oldal)
Hivatalos OpenAI-példány: Technikai jelentés (PDF)
Kapcsolódó közlemény: OpenAI: Our approach to EU text provenance rules
A University of Pennsylvania, a Yale University és az OpenAI kutatóinak közös, húszoldalas technikai jelentése. Az eljárás matematikai alapjait, működését és ellenőrzési módszerét ismerteti. A dokumentum nem függetlenül lektorált folyóiratközlemény.
Új irány az MI-generált szövegek eredetének azonosításában
A mesterséges intelligenciával létrehozott szövegek felismerése az elmúlt évek egyik jelentős technológiai és társadalmi kérdésévé vált világszerte.
A fejlesztések egyik iránya a már elkészült szövegek elemzésére épül: különböző nyelvi és statisztikai jellemzők alapján próbálja megállapítani, hogy egy szöveget ember vagy nyelvi modell hozott-e létre. Ezek az eljárások azonban nem képesek minden esetben megbízhatóan azonosítani a szöveg eredetét.
Ezzel párhuzamosan egy másik fejlesztési irány is egyre nagyobb figyelmet kap: a digitális tartalmak eredetének követhetősége (content provenance). Ennek egyik eszköze a digitális vízjelezés, amely már a szöveg létrehozásakor rejtett, statisztikailag kimutatható mintázatot épít a generálási folyamatba. Ez a mintázat később támpontot adhat a szöveg eredetének ellenőrzéséhez.
Ebbe a fejlesztési irányba illeszkedik a 2026. október 5-én bemutatott textGrain, amelyet a Pennsylvaniai Egyetem, a Yale Egyetem és az OpenAI kutatói dolgoztak ki. A technológia az entrópiához igazított szövegvízjelezésre (entropy-calibrated watermarking) épül. Lényege, hogy a nyelvi modell által generált szövegben felismerhető statisztikai mintázatot hozzon létre, miközben szabályozza, mennyivel csökkenhet a tokenválasztás véletlenszerűsége.
A textGrain jelentősége tehát nem önmagában a vízjelezés ötletében rejlik, hiszen korábban is születtek hasonló megoldások. Újdonsága abban áll, hogy információelméleti alapokon szabályozza a vízjel erőssége és a szöveggenerálás során megőrzött véletlenszerűség közötti viszonyt.
A fejlesztés ugyanakkor új kérdéseket is felvet. Mennyire marad felismerhető a vízjel, ha a szöveget átfogalmazzák vagy lefordítják? Hogyan működik a módszer különböző nyelveken és szövegtípusokban? Milyen szerepet kaphat az MI-vel készült tanulói munkák eredetének vizsgálatában? E kérdések megválaszolásához először a textGrain informatikai működését és alapfogalmait érdemes megismernünk.
A fejezet technológiai állításait Li és munkatársai (2026, 1–3. o.) támasztják alá. textgrain-entropy-calibrated-watermarking-for-language-model-text.pdf
Hogyan működik a láthatatlan szövegvízjel?
A textGrain működésének megértéséhez először azt kell megvizsgálnunk, hogyan hoz létre szöveget egy nagy nyelvi modell, és milyen szerepet játszik ebben a véletlenszerűség.
A szöveggenerálás alapja: a tokenválasztás
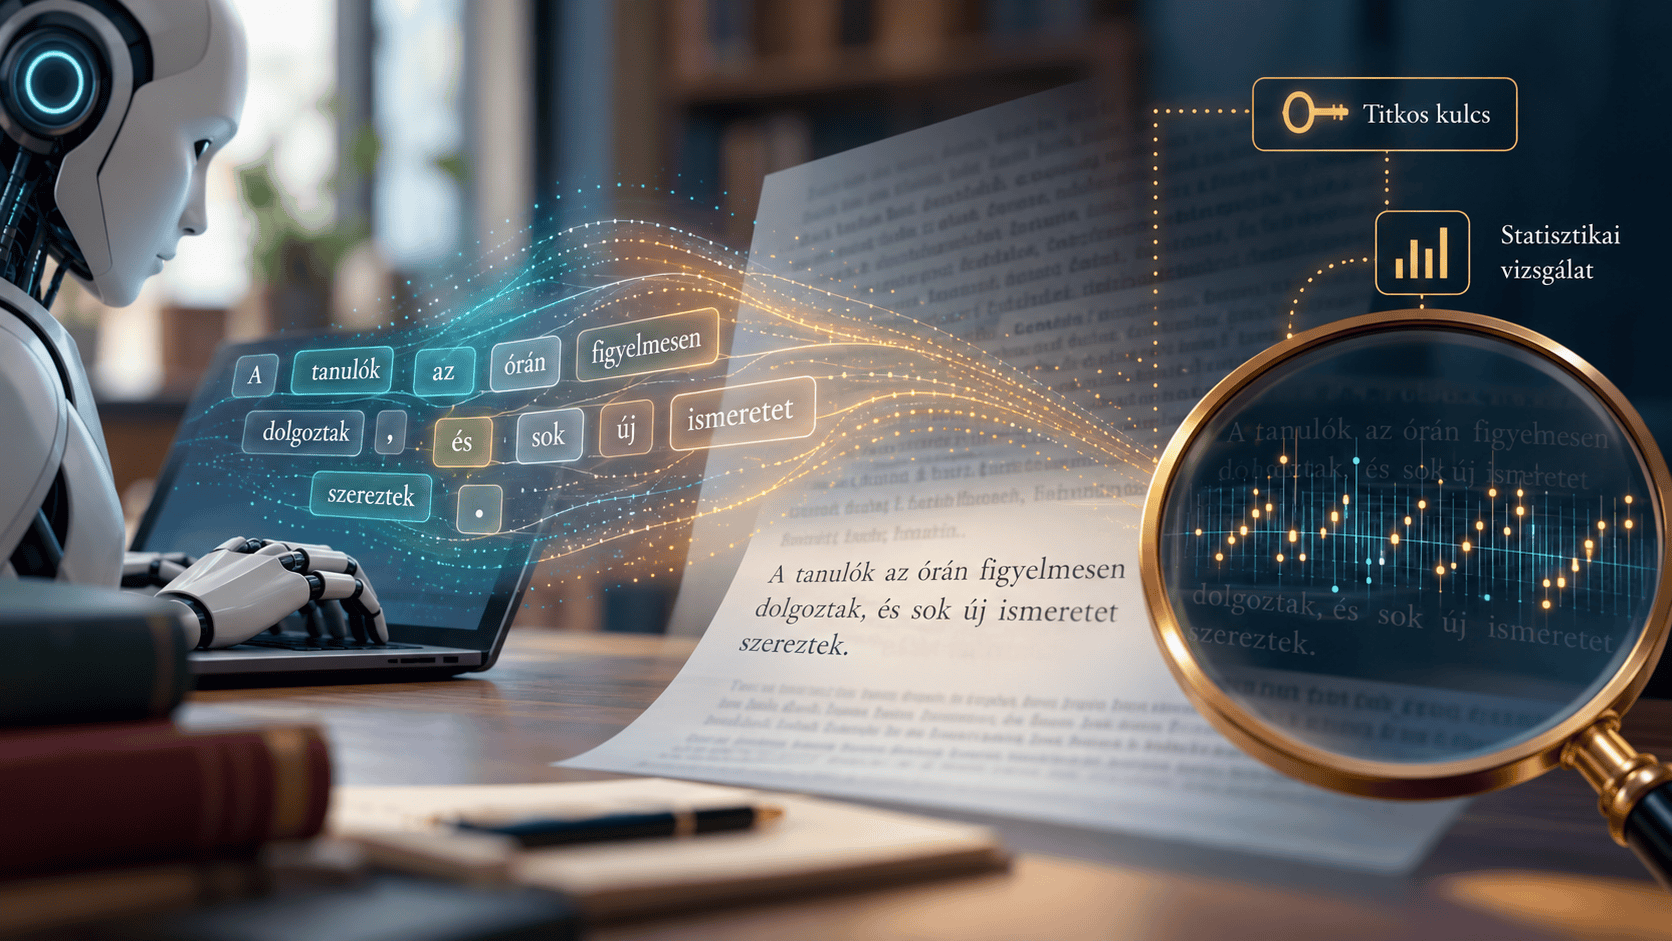
A nyelvi modellek a szöveget kisebb egységekre, úgynevezett tokenekre bontva dolgozzák fel. Egy token lehet teljes szó, szórész vagy írásjel is. A modell a megelőző szöveg alapján minden újabb lépésben meghatározza a lehetséges következő tokenek valószínűségi eloszlását. Vegyük például a következő mondatkezdetet: „A tanulók az órán figyelmesen…” A folytatás lehet „dolgoztak”, „hallgattak” vagy „jegyzeteltek”. Ezek itt a lehetséges szóválasztásokat szemléltetik; a modell ténylegesen tokeneket választ, amelyek nem feltétlenül esnek egybe a teljes szavakkal. A lehetséges folytatásokhoz különböző valószínűségeket rendel, majd a generálási beállításoknak megfelelően választ közülük. A szöveggenerálás tehát nem előre rögzített mondatok előhívása, hanem egymást követő, valószínűségi alapú választások folyamata.
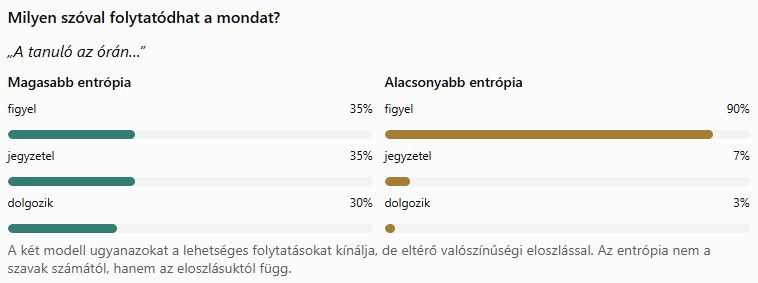
1. ábra: saját szerkesztésű szemléltetés, fiktív valószínűségi eloszlásokkal.
Az adatok nem a textGrain kísérleti eredményei.
Mit jelent az entrópia?
Az entrópia az információelmélet egyik alapfogalma: egy valószínűségi eloszlás bizonytalanságát jellemzi. Ha a modell több, hasonlóan valószínű folytatás közül választhat, az entrópia viszonylag magas. Ha viszont egyetlen folytatás sokkal valószínűbb a többinél, az entrópia alacsonyabb.
Az entrópia tehát nem egyszerűen a lehetséges folytatások számától, hanem azok valószínűségi eloszlásától függ. A textGrain szempontjából ez azért fontos, mert a vízjel beépítése kapcsolatot teremt a tokenválasztás és egy titkos kulccsal előállított véletlenszerű érték között. A fejlesztők célja, hogy ez a kapcsolat ellenőrizhető legyen, miközben a generálás véletlenszerűségéből a lehető legtöbbet megőrzik.
Hogyan kerül a vízjel a szövegbe?
A textGrain nem láthatatlan karaktereket vagy különleges írásjeleket helyez el a szövegben. Ehelyett a tokenek kiválasztásának valószínűségi mechanizmusát módosítja.
A rendszer egy titkos kulcs és a megelőző szövegkörnyezet alapján pszeudovéletlen értékeket állít elő. A lehetséges tokeneket a kulcs segítségével csoportokba rendezi, majd meghatározza, milyen valószínűséggel választhatók ki az egyes csoportok. A kiválasztott csoporton belül a tokenek egymáshoz viszonyított eredeti valószínűsége megmarad. Az eljárás az optimális transzport (optimal transport) matematikai módszerére épül. Ennek segítségével olyan kapcsolatot alakít ki a tokenválasztás és a kulccsal meghatározott értékek között, amely a kész szövegben statisztikailag vizsgálható.
A módszer újdonsága az entrópiaveszteség szabályozása. A szerzők ezt a következőképpen fogalmazzák meg: “The KL penalty is therefore exactly the average entropy removed by watermarking.” – azaz a KL-büntetőtag tehát pontosan megegyezik a vízjelezés által okozott átlagos entrópiacsökkenéssel. (Saját fordítás)
Az idézet forrása: Li és munkatársai (2026), 2. fejezet, 2. oldal, Information and entropy. Textgrain-entropy-calibrated-watermarking-for-language-model-text.pdf, A működés részletei a jelentés 3.1–3.2. alfejezeteiben olvashatók.
A megállapítás lényege, hogy a fejlesztők matematikailag számszerűsíteni tudják, mennyi véletlenszerűséget veszít a tokenválasztás a vízjel létrehozása miatt. A vízjel erőssége és a megőrzött véletlenszerűség közötti kapcsolat így szabályozható. Fontos ugyanakkor, hogy ez a szabályozás átlagos entrópiaveszteségre vonatkozik: nem garantál azonos mértékű veszteséget minden egyes tokenválasztásnál vagy rögzített titkos kulcs mellett.
Hogyan ismerhető fel a vízjel?
Az ellenőrzés során a rendszer a kész szöveget és ugyanazt a titkos kulcsot használja. A szöveg tokenjeiből és a megelőző szövegkörnyezetből újra előállítja a vízjelezéshez kapcsolódó pszeudovéletlen értékeket. A detektor ezután megvizsgálja, hogy a megfigyelt tokenek és a kulccsal előállított értékek között kimutatható-e a vízjelezett generálásra jellemző statisztikai kapcsolat.
A felismerés tehát nem egy elrejtett azonosító kiolvasása, hanem statisztikai bizonyíték keresése arra, hogy a szöveg a vízjelezett generálási eljárással keletkezett. Az eredmény ezért nem tévedhetetlen: a vízjel felismerésének és hiányának értelmezésekor egyaránt figyelembe kell venni a statisztikai próba hibalehetőségeit.
Mit mutatnak a textGrain kísérleti eredményei?
A textGrain hatékonyságát az OpenAI különböző hosszúságú és témájú szövegeken vizsgálta. A 2026. október 5-én közzétett eredmények szerint a vízjel felismerhetőségét jelentősen befolyásolja a szöveg hossza, jellege és utólagos módosítása.
A szöveghossz szerepe
A vízjel kimutatása statisztikai vizsgálaton alapul, ezért a hosszabb szövegek általában több lehetőséget kínálnak a jel felismerésére. Az OpenAI pszichológiai témájú kérdésekre adott válaszoknál a 200 tokenes szövegrészletek körülbelül 80%-ában, a 400 tokenes részletek mintegy 95%-ában ismerte fel a vízjelet.
A vizsgálatban a detektor döntési küszöbét 1%-os célzott tévespozitív-arányhoz igazították. A téves pozitív eredmény azt jelenti, hogy a rendszer olyan szövegben is vízjelet jelez, amely nem tartalmazza azt. Az 1%-os célérték azonban nem garantálja, hogy a detektor minden alkalmazási környezetben ugyanilyen hibaaránnyal működik. Az eredmények alapján a rövidebb szövegekben a vízjel felismerése kevésbé megbízható lehet.
Nem mindegy, milyen szöveget vizsgálunk
A kutatók jelentős különbségeket tapasztaltak a különböző témájú szövegek között. A pszichológiai kérdésekre adott válaszokban a vízjel könnyebben felismerhető volt, mint a matematikai tartalmú szövegekben.
Ennek egyik magyarázata, hogy a matematikai feladatok megoldásakor a megfelelő folytatások köre gyakran szűkebb. A szabadabban megfogalmazható válaszokban többféle nyelvi megoldás lehetséges, ami nagyobb mozgásteret biztosíthat a vízjelezés számára. A felismerés eredményessége tehát nem kizárólag az alkalmazott technológiától, hanem a generált szöveg sajátosságaitól is függ.
Mi történik, ha átszerkesztjük a szöveget?
A kísérletek egyik legfigyelemreméltóbb eredménye a vízjel utólagos szerkesztéssel szembeni sérülékenységéhez kapcsolódik. Az OpenAI 400 tokenes, angol nyelvű szövegeken vizsgálta, hogyan változik a felismerési arány, ha a szavak egy részét szinonimákra cserélik. A változatlan szövegekben a vízjel felismerési aránya megközelítőleg 92% volt. A szavak 10%-ának kicserélése után ez 66%-ra, 25%-os szinonimacsere esetén pedig 17%-ra csökkent.
Az eredmények azt mutatják, hogy viszonylag korlátozott lexikai módosítás is jelentősen gyengítheti a vízjel statisztikai jelét. Ebből azonban nem következik, hogy minden átfogalmazás azonos hatással járna. A közölt adatok meghatározott angol nyelvű szövegekre és szerkesztési eljárásra vonatkoznak.
A szinonimacsere hatása a vízjel felismerésére.
400 tokenes angol nyelvű szövegek · Felismerési arány (%)
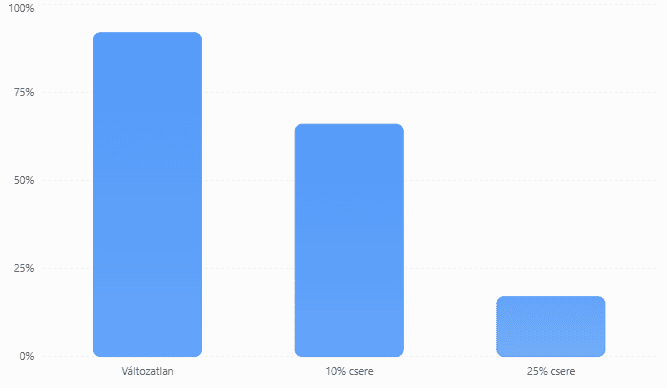
2. ábra: saját szerkesztés az OpenAI (2026) kísérleti adatai alapján.
Az értékek közelítőek, angol nyelvű szövegekre vonatkoznak.
Befolyásolja-e a vízjel a generált szövegek minőségét?
A textGrain fejlesztésének további fontos kérdése, hogy a vízjelezés befolyásolja-e a nyelvi modell teljesítményét. Az OpenAI saját összehasonlító vizsgálataiban a vízjelezett és a vízjel nélküli modellváltozatok több teljesítményteszten hasonló eredményeket értek el. Az egyes tesztekben kisebb pozitív és negatív eltérések egyaránt előfordultak.
A mérések alapján a fejlesztők nem tapasztaltak érdemi általános teljesítményromlást. Ez azonban nem bizonyítja, hogy a vízjelezés minden nyelven, szövegtípusban és felhasználási helyzetben azonos hatással jár.
Mit következtethetünk az eredményekből?
A textGrain a vizsgált körülmények között nagy arányban felismerhető statisztikai vízjelet képes létrehozni. A kísérletek ugyanakkor azt is megmutatják, hogy a felismerés megbízhatósága nem állandó: függ a szöveg hosszától, jellegétől és későbbi módosításaitól.
Különösen fontos különbséget tenni a vízjel felismerése és a szöveg szerzőségének bizonyítása között. A sikeres felismerés a vízjelezett generálásra utaló statisztikai bizonyíték, nem pedig annak igazolása, hogy a teljes szöveg emberi közreműködés nélkül készült. A vízjel hiánya pedig önmagában nem bizonyítja az emberi szerzőséget. Az eredmények így egy további kérdéshez vezetnek: milyen kapcsolat van a szöveg nyelvi megformálása és a vízjel fennmaradása között?
A módszer korlátaira egy későbbi, független elméleti vizsgálat is rámutatott: Bhattacharyya és Bonnerjee (2026) matematikai modelljükben azt találták, hogy a textGrain kimutathatósági tartománya bizonyos feltételek mellett szűkebb, mint egyes korábbi vízjelezési eljárásoké.
A fejezet adatai és megállapításai az OpenAI Our approach to EU text provenance rules című, 2026. október 5-i közleményének „How our watermarking works and performs” és „Impact of watermarking on output quality” szakaszaira épülnek.
Nyelvészeti hatások: mi történik a vízjellel, ha a szöveg megváltozik?
A textGrain nyelvészeti szempontból is fontos kérdéseket vet fel. A vízjel ugyanis nem közvetlenül a szöveg jelentéséhez, hanem a generálás során kiválasztott tokenekhez és azok statisztikai mintázatához kapcsolódik. Ezért a nyelvi módosítás akkor is befolyásolhatja a vízjel felismerhetőségét, ha a szöveg tartalma lényegében változatlan marad.
A szinonimák szerepe
A szinonímia lehetővé teszi, hogy egy gondolatot különböző szavakkal fejezzünk ki. A szinonimák azonban nem minden szövegkörnyezetben helyettesíthetik egymást jelentésváltozás nélkül.
Vegyük például a következő mondatot: „A kutatók jelentős eredményeket értek el a vizsgálat során.” A mondat átfogalmazható így is: „A szakemberek számottevő eredményekre jutottak a kutatás folyamán.”
A két mondat tartalma hasonló, nyelvi megformálásuk viszont különbözik. A szavak cseréje módosíthatja a tokenek sorozatát, és ezzel a vízjel felismerhetőségét is. Az OpenAI kísérleteiben már a szavak 10%-ának szinonimákra cserélése is jelentősen csökkentette a felismerési arányt. A vizsgálat eredményei arra utalnak, hogy a statisztikai vízjel viszonylag kisebb lexikai módosításokra is érzékeny lehet (OpenAI, 2026).
Morfológiai és mondatszerkezeti átalakítások
A szöveg módosítása nem korlátozódik a szavak cseréjére. Azonos vagy hasonló tartalmat eltérő alaktani és mondatszerkezeti megoldásokkal is kifejezhetünk. Például:
„A tanulók megoldották a feladatokat.”
„A feladatok megoldása megtörtént.”
A két mondat hasonló eseményre utal, de eltérő nyelvtani szerkezetet alkalmaz. Az elsőben az igealak és annak toldalékai fejezik ki a cselekvést, a másodikban a „megoldás” főnév és a „megtörtént” ige alkotja az állítmányi szerkezetet. A második mondatban a cselekvő személye sem jelenik meg. A mondatszerkezet a szórend megváltoztatásával is módosulhat:
„A tanár értékelte a diákok munkáját.”
„A diákok munkáját a tanár értékelte.”
A két mondat alapvető állítása azonos, de információs szerkezetük eltér: más mondatrész kerül előtérbe. A vízjelezés szempontjából ezek az átalakítások azért lehetnek jelentősek, mert nemcsak az egyes tokeneket, hanem azok sorrendjét és a későbbi tokenválasztások szövegkörnyezetét is megváltoztathatják.
Mit jelent mindez a magyar nyelv esetében?
A magyar nyelv gazdag toldalékrendszere és információszerkezeti szempontból meghatározott szórendje különösen érdekes vizsgálati lehetőségeket kínál. Egy szóalak módosítása eltérő tokenizációt eredményezhet, míg a szórend átalakítása a tokenek egymásutánját és a generálás szövegkörnyezetét is befolyásolja.
Ezekből a nyelvészeti sajátosságokból azonban nem következik automatikusan, hogy a textGrain magyar nyelven kevésbé hatékonyan működne. Az OpenAI ismertetett szinonimacserés kísérlete angol nyelvű szövegeken készült, így nem szolgáltat közvetlen bizonyítékot a magyar nyelvű alkalmazás megbízhatóságára. Ennek megállapításához külön magyar nyelvű vizsgálatokra lenne szükség.
Fordítás és átfogalmazás
A fordítás további kihívást jelent a szövegek eredetének ellenőrzésében. Egy másik nyelvre átültetett szöveg megőrizheti az eredeti gondolatmenetet, miközben szókészlete, alaktani és mondatszerkezeti felépítése jelentősen átalakul.
Hasonló jelenség figyelhető meg a parafrázis, vagyis a tartalom más nyelvi formában történő újrafogalmazása során. Az OpenAI közleménye szerint az átszerkesztett vagy lefordított szövegekben a vízjel felismerése bizonytalanná válhat. A fordítás hatásáról azonban az ismertetett szinonimacserés adatok alapján nem lehet pontos, számszerű következtetést levonni.
A jelentés és a nyelvi forma különbsége
A nyelvészeti kérdések közös alapja a jelentés és a nyelvi megformálás viszonya. Két szöveg közvetíthet hasonló információt eltérő szavakkal, szóalakokkal és mondatszerkezetekkel. A textGrain viszont a konkrét tokensorozathoz kapcsolódó statisztikai mintázatot vizsgálja, nem a szövegek jelentésbeli azonosságát, ezért a jelentés megőrzése önmagában nem garantálja a vízjel fennmaradását.
Ez a különbség különösen fontossá válik az oktatásban, ahol egy tanulói szöveg önálló munkával, mesterséges intelligencia segítségével vagy MI-generált szöveg átdolgozásával is létrejöhet. A különböző alkotási folyamatok megítéléséhez a vízjel önmagában nem szolgáltat elegendő információt.
A szinonimacserére és fordításra vonatkozó megállapításokat az OpenAI közleménye támasztja alá. OpenAI A tokenek és a megelőző szövegkörnyezet szerepét Li és munkatársai (2026, 2–6. o.) írják le.
MI-detektálás és tanulói szerzőség: mit bizonyíthat a vízjel?
A mesterséges intelligenciával létrehozott szövegek azonosítása az oktatásban különösen érzékeny kérdés. Egy tanulói dolgozat esetében ugyanis nem elegendő azt megállapítani, hogy a szöveg elkészítéséhez használtak-e MI-t. Azt is vizsgálni kell, milyen szerepet játszott a tanuló a gondolatok kialakításában, a szöveg megfogalmazásában és átdolgozásában.
A textGrain ebben korlátozott segítséget nyújthat. A vízjel sikeres felismerése statisztikai bizonyítékot szolgáltathat arra, hogy a vizsgált szöveg vízjelezett nyelvi modell kimenetéből származik. Nem bizonyítja azonban, hogy a teljes dolgozatot mesterséges intelligencia készítette, és azt sem, hogy a tanuló szabálytalanul járt el.
Ugyanígy a vízjel hiánya sem igazolja az önálló szerzőséget. A szöveg készülhetett vízjel nélküli modellel, vagy a vízjel felismerhetősége sérülhetett az utólagos szerkesztés során. A pedagógiai értékelésben ezért három kérdést érdemes elkülöníteni: történt-e MI-használat, milyen mértékű volt a tanuló önálló szellemi hozzájárulása, és megfelelt-e az alkalmazott munkamódszer a feladat előírásainak.
Az MI használata önmagában nem feltétlenül szabálytalanság. Megítélése az adott feladat céljától és követelményeitől függ. A textGrain és a hozzá hasonló technológiák támogathatják a szövegek eredetének vizsgálatát, de nem helyettesíthetik az alkotási folyamat és az önálló tanulói teljesítmény pedagógiai értékelését.
A vízjel statisztikai ellenőrzésének működését és hibalehetőségeit Li és munkatársai (2026, 5–6. o.) ismertetik. A tanulói értékelésre vonatkozó következtetések saját pedagógiai értelmezéseink, nem a technikai jelentésben vizsgált kísérleti eredmények.
Összegzés
A textGrain az MI-generált szövegek eredetjelölésének újabb jelentős fejlesztése. A hagyományos, utólagos szövegdetektálással szemben már a generálás során statisztikailag felismerhető vízjelet hoz létre. Technológiai újdonsága, hogy információelméleti alapon szabályozza a vízjel kialakítása és a tokenválasztás véletlenszerűségének megőrzése közötti viszonyt.
A közölt kísérleti eredmények ugyanakkor a módszer korlátaira is rámutatnak. A vízjel felismerhetősége függ a szöveg hosszától, jellegétől és utólagos módosításaitól. A különböző nyelveken történő alkalmazás, különösen a nyelvi átalakítások hatása további vizsgálatokat igényel.
A textGrain jelentősége ezért nem abban áll, hogy véglegesen megoldaná az MI-generált szövegek azonosításának problémáját, hanem abban, hogy új lehetőséget kínál a digitális tartalmak eredetének ellenőrzésére. A szöveg technológiai eredetének felismerése azonban nem azonos a szerzőség bizonyításával. Ez a különbségtétel különösen fontos az oktatásban, ahol a tanulói teljesítmény megítélésének továbbra is az önálló gondolkodásra, az alkotási folyamatra és az elvégzett munkára kell épülnie.
Ajánlott irodalom és további olvasnivalók
Tudományos kutatások
Bhattacharyya, Swapnaneel – Bonnerjee, Soham (2026): textGrain watermarking is harder to detect: can sum-tests still do it optimally? arXiv, 2026. október 13. Teljes tanulmány
A textGrain kimutathatóságának elméleti korlátait, valamint a statisztikai próbák hatékonyságát vizsgáló független kutatási preprint. A szerzők matematikai modellben elemzik az utólagos szövegszerkesztés hatását, és új, hatékonyabb felismerési eljárást javasolnak.
Dathathri, Sumanth és munkatársai (2024): Scalable watermarking for identifying large language model outputs. Nature, 634, 818–823. Teljes tanulmány
A Google DeepMind SynthID-Text vízjelezési eljárását ismertető, lektorált és nyílt hozzáférésű tudományos közlemény. A textGrain egyik fontos technológiai előzményének megismeréséhez ajánlott.
Technológiai háttérelemzések
Axon, Samuel (2026): OpenAI will watermark ChatGPT outputs by default—but only in the EU. Ars Technica, 2026. október 6. Cikk megnyitása
A bevezetés szabályozási hátterét és a technológia megbízhatósági korlátait ismertető kritikai összefoglaló.
TechCrunch (2026): OpenAI will start watermarking ChatGPT’s text in the EU. 2026. október 5. Cikk megnyitása
A textGrain bejelentését, működési elvét és gyakorlati bevezetését bemutató technológiai beszámoló.
The Verge (2026): OpenAI is adding text watermarking in ChatGPT and Codex. Cikk megnyitása
A vízjelezés európai bevezetéséről, az ellenőrzőeszközhöz való hozzáférésről és a technológia értelmezési korlátairól szóló áttekintés.